负责串联各制作环节。某个镜头失败时保留进度,下次只补做缺失内容。
项目 01 · 2026.04 — 2026.05 · 个人开发
AIGC自动化静态漫剧产线项目
主要职责
- 梳理小说内容:按完整句拆解原文,核对人物、场景和关键情节;发现缺失段落时及时补齐,避免长篇故事在改编中断片。
- 保障制作进度:逐段检查剧本与分镜结果,记录出错或未完成的镜头;重新制作时只处理缺失部分,减少重复工作。
- 统一角色形象:依据原文确定角色外观、服装与辨识特征,制作角色参考图,并在每个镜头中沿用。
- 把控画面表达:为角色、场景和镜头整理提示词,明确人物动作、画面重点与前后衔接,让出图服务于剧情。
工作流工具栈
- n8n
- ComfyUI
- LoRA 预训练
- Coze
- FFmpeg
- 自研剪映自动化工具
01 / 产线总览
自动化产线总览
从小说原文出发,依次梳理章节、人物和场景,完成剧本与分镜,再生成画面、配音和字幕。最后既可输出视频,也可保留可继续修改的剪辑工程。
分别处理故事理解、剧本、人物设定、画面描述与结果检查。
集中保存原文、人物、场景和分镜资料,让后续环节沿用同一份信息。
将画面、字幕和配音编排成视频,同时保留可继续编辑的剪映工程。
02 / 流程设计
制作中遇到的问题与处理
稳定性与异常处理
逐段检查剧本内容与分镜是否完整。遇到异常时记录原因和进度,修正后从出错位置继续,不必重新制作整章。
长文与数据完整性
按完整句拆解长篇原文,并核对每段是否进入剧本。对白过长时拆分到连续镜头,确保字幕和配音能够完整呈现。
一致性与连贯性
统一角色形象,保留原文对白并标注说话人与情绪,避免旁白混入对白;相邻镜头延续场景和动作,让画面切换更连贯。
素材管理与衔接
整理素材命名和保存位置,将角色参考图与生成画面对应到各自记录,方便查找、复核和继续制作。
03 / 工作流全景
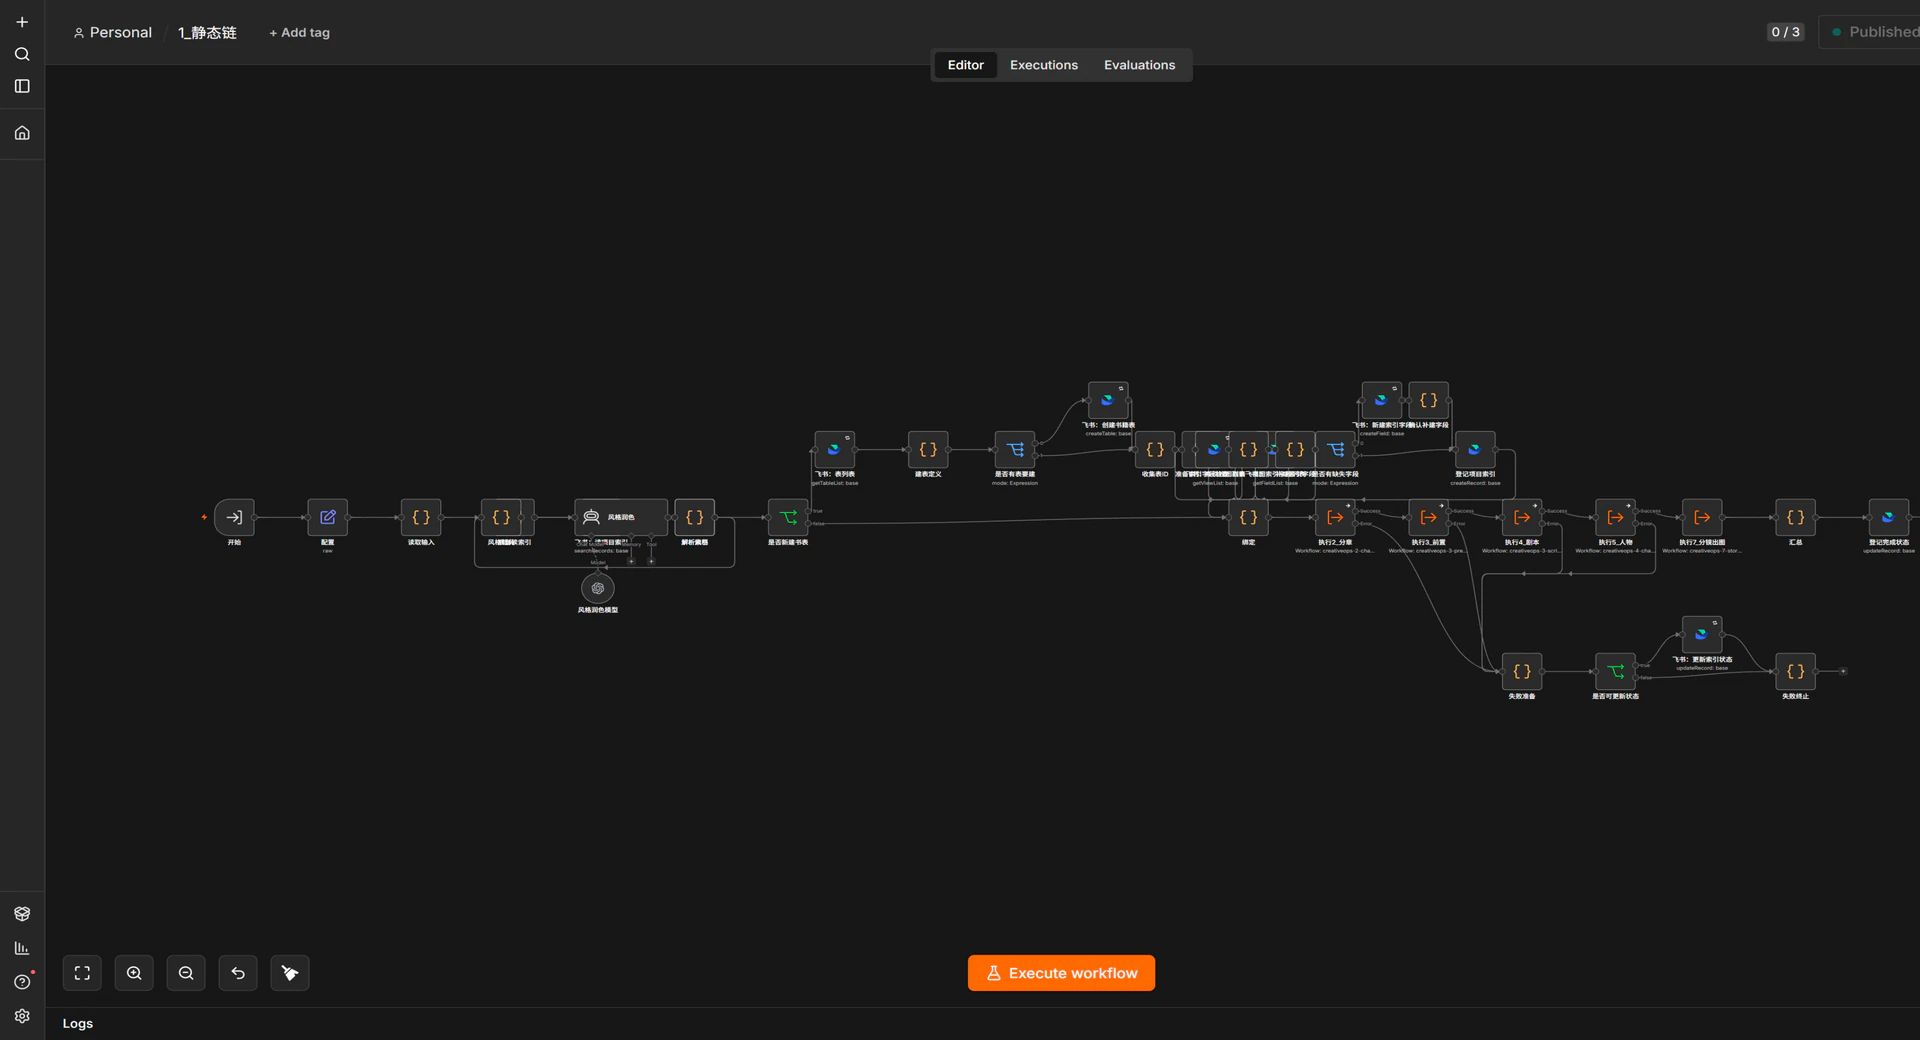
工作流全景
以下展示从小说输入到成片输出的主要制作环节。早期分镜方案也保留在其中,方便查看流程如何调整。点击图片可查看完整画布。
04 / 成片路径
从图文素材到剪映成片。
根据镜头描述生成画面,再将图片、字幕和配音按顺序放入剪映工程,形成可继续编辑的成片。
01 / 生成镜头画面
按镜头描述生成画面
根据分镜中的人物、场景和动作描述生成画面,供后续成片使用。
02 / 编排成片
画面、字幕与配音汇成一集
画面、字幕和配音按镜头顺序排入剪映工程,不同人物使用对应的字幕与声音。
成片展示
《风铃中的刀声》样例
从小说片段整理人物和镜头,再将画面、字幕与配音编排成可观看的样例。
05 / 数据底座
飞书多维表格即生产数据。
人物、场景、剧本与分镜等资料集中整理在同一处,方便检查前后是否一致,也方便从未完成的镜头继续制作。以下是《风铃中的刀声》的制作记录。
06 / 提示词约束撰写
让角色与画面保持一致的提示词。
提示词把角色外观、画面风格和镜头要求写清楚,让不同阶段生成的内容能够衔接。下面展示这集样例使用的两条提示词。
Role:角色形象设计师 · 故事视觉资产契约(点击展开全文)
# Role:角色形象设计师

输入是人物目录(含每人的一句话身份和原文证据句)与全局画面风格。为**每一个**角色产出固定视觉形象,同一故事范围内的所有分镜共用,不可漂移。

## 输入

- `characters`:character_id、canonical_name、one_line_identity、evidence(≤3 句含此人称呼的原文句)。
- `style_prompt`:全局画面风格。

## 设计规则

1. `fixed_appearance` 一段完整描述,依次包含:性别与年龄段、发色发型、瞳色、体型身量、服装基调(颜色+材质+款式)、一个**核心标识元素**。能从 evidence 里找到的外貌线索必须采用;原文没有的部位给出合理默认,风格与全局一致。
2. 核心标识元素 = 一眼认出此人的具象物件或特征(如"左眉骨旧疤""霜银长发""赤纹护腕"),在 fixed_appearance 中具体写出,并单独提炼为 `core_visual_token`(一个短语)。
3. **故事范围内不变**:发色、瞳色、核心标识元素永不改变。服装基调保持稳定,除非身份变化需要(此时仍保留核心标识元素)。
4. **角色间差异**:任何两个角色的发色组合、核心标识元素不得相同;主要角色之间发型轮廓与色彩主调必须可区分。
5. 龙套角色从简:性别年龄段+一两个固定特征+职业着装,不强求标识元素(core_visual_token 可为空字符串)。
6. 不写剧情、不写性格、不写与画面无关的内容;描述里不使用括号备注。

## 输出

只输出一个 JSON 对象,覆盖输入目录的**每一个**角色,不增不减,无 Markdown、无解释:

{
  "characters": [
    { "character_id": "C01", "canonical_name": "莫青峰", "fixed_appearance": "青年男性,黑发高束……", "core_visual_token": "左眉骨旧疤" }
  ]
}
Role:静态漫分镜师 · 场次拆镜契约(点击展开全文)
# Role:静态漫分镜师

把当前场次拆成 1-4 个连续镜头(shot)。输入的 `characters` 已带每人固定外观,`scene` 已带场景视觉描述,你只负责镜头语言。

## 输入

- `script_scene`:一个场次(action / dialogues / narration / quote / character_ids)。
- `characters`:本场次人物,含 character_id、canonical_name、fixed_appearance。
- `scene`:scene_id、scene_name、visual_prompt。
- `context`:上一场次与下一场次各一句话,用于衔接。
- `style_prompt`:全局风格(你不用写进 composition,程序会合成)。

## 拆镜规则

1. 场次里有对白:每个镜头承载 1-2 句对白,说话者必须在画面中;关键台词给特写或中特写。
2. 无对白的动作场次:按动作节拍拆 1-2 镜。
3. 纯环境交代(`narration` 且无人):给一个空镜。
4. 本场次某角色**首次**出场:先给一个全身或大半身展示镜。
5. 镜头顺序必须能连读成戏,与 context 衔接(上场结尾的人物位置在本场延续)。

## 镜头字段

- `shot_kind`:人物镜 / 空镜 / 群像。
- `composition`:30-60 字。格式"景别:画面内容"。景别用特写/中特写/中景/全景/远景。画面内容必须具体可视:人物动作、站位、视线、关键物件、环境要素。**禁止**抽象情绪词(写"攥紧的拳"不写"愤怒")。
- `character_ids`:本镜中出现的人物(空镜为空数组),只能用输入目录里的 ID。
- `dialogue_text`:本镜要呈现的台词原文(可合并 1-2 句),无台词为空字符串。

## 输出

只输出一个 JSON 对象,无 Markdown、无解释:

{
  "shots": [
    { "shot_kind": "人物镜", "composition": "中特写:莫青峰攥紧军报指节发白,目光钉在火漆封印上,篝火在他侧脸跳动。", "character_ids": ["C01"], "dialogue_text": "这军报是假的。" }
  ]
}
把章节、人物、场景和分镜逐步整理成可追溯的制作资料。每个镜头都能找到对应的原文依据,方便核对故事内容。
① 原文整章章节表.原文
完整保留不拆散
完整保留不拆散
② 分句单元unit_id
FLLDDS-SRC-2-16
FLLDDS-SRC-2-16
③ 人物·场景普查names / identity
+ evidence 证据句
+ evidence 证据句
④ 逐章剧本场次 / action
/ dialogues
/ dialogues
⑤ 逐镜分镜景别 · 运镜 · 台词JSON
character_id+unit_id
character_id+unit_id
⑥ 成图附件状态=已出图
附件挂行即断点
附件挂行即断点
07 / 角色资产
角色三视图资产库。
根据小说中的外貌线索设计角色,并制作正面、侧面与背面参考图,供后续镜头统一人物形象。点击图片可查看原图。
08 / 逐镜成图
生产出来的分镜图。
以下选取不同章节和景别的九张分镜画面,展示人物与场景如何呈现在镜头中。点击图片可查看原图。